
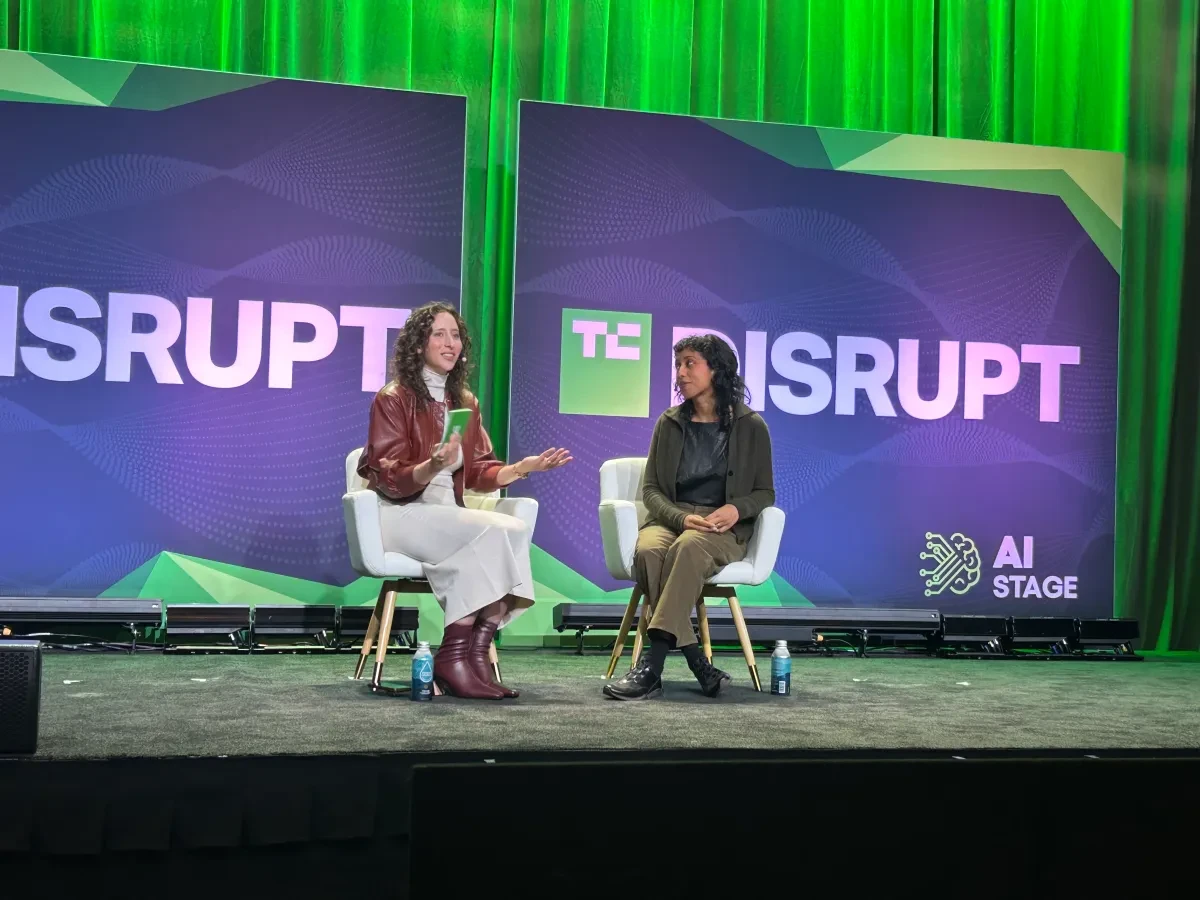
راهنت مختبرات الذكاء الاصطناعي بسمعتها على اختبارات قياس أداء النماذج، وهي منظومة تقييمات يُفترض أنها محايدة ودقيقة، وصُممت لتحديد ما إذا كان منتج ذكاء اصطناعي يتفوق على آخر.
غير أن إيرين سولايمان (Irene Solaiman)، كبيرة مسؤولي السياسات في شركة «هاغينغ فيس» (Hugging Face)، رأت أن المنهجيات التي تقوم عليها هذه التقييمات معقدة ولا تزال في طور النضج. وأوضحت، خلال نقاش في مؤتمر «تك كرانش ديسربت» (TechCrunch Disrupt) الأسبوع الماضي، أن الاختبارات بحاجة إلى أن تتبلور في إطار علمي أكثر اتساقًا إذا أرادت الصناعة الاعتماد عليها مستقبلًا.
اقرأ أيضًا: غوغل تطلق أداة «يونيفرسال كارت» للتسوق في الولايات المتحدة
ومن هنا يبرز السؤال: هل يمكن الوثوق بالاختبارات التي تُنشر حاليًا؟
تجيب سولايمان: «الثقة مصطلح مثقل بالدلالات. وفيما يتعلق بإمكانية الوثوق بالنتائج، فإن جانبًا كبيرًا من المسألة يتمثل في: هل يمكنك إعادة إنتاج نتائج التقييم؟ وهل تملك مستوى الوصول الذي تحتاجه إلى النموذج نفسه؟ هنا تحديدًا تؤدي الأوزان المفتوحة دورًا كبيرًا».
وظلت قابلية إعادة إنتاج نتائج تقييم النماذج طويلًا من أكثر الجوانب استعصاءً في عملية قياس الأداء، ولا تزال موضع جدل واسع داخل الصناعة.
وإلى جانب مدى صلاحية كل اختبار على حدة، تُطرح مسألة أخرى تتعلق بكيفية مقارنته بغيره من التقييمات. وقالت سولايمان في هذا الصدد: «إنها علم آخذ في التطور، ولا نعرف كيف نقارنها ببعضها بعضًا مقارنة ذات معنى».
وأضافت: «تبدأ هذه التقييمات في فقدان فاعليتها بسرعة نسبيًا، ولا نملك منظومة مزدهرة بالقدر الذي نحتاجه. هناك الآن تعطش لمنظومة من المقيّمين المدمجين، لكن المؤهلات التي تحدد من هو المقيّم الفعّال وفي أي المهام تحتاج إلى قدر أكبر بكثير من التوحيد المعياري».
واكتسبت فكرة المقيّمين المدمجين، التي تقوم على وضع مراقبين من أطراف خارجية يُفترض أنهم «محايدون» داخل مؤسسات الذكاء الاصطناعي، رواجًا خلال الأشهر الماضية، في وقت تواجه فيه المختبرات موجة من الحوادث المتعلقة بالسلامة أثارت مخاوف من الأضرار المحتملة لتقنياتها. وكانت «هاغينغ فيس» نفسها هدفًا لإحدى هذه الحوادث التي ذاع صيتها.
وبدلًا من تنظيم حكومي فاعل يتولى رصد مخاوف سلامة النماذج والحد منها، دفعت المختبرات باتجاه حل الطرف الثالث. إلا أن الشكوك لا تزال قائمة حول مدى حياد هؤلاء المقيّمين وفاعليتهم في الواقع. فقد أثار قرار شركة «أنثروبيك» التعاقد مع «أكسنتشر» (Accenture) لتكون أول مقيّم لديها موجة من الانتقادات، إذ سخر بعض المنتقدين من فكرة أن شركة الاستشارات مؤهلة للقيام بهذه المهمة.
وتتجه التقييمات حاليًا إلى تجاوز اختبار النموذج وحده، لتشمل المنظومة المحيطة به بأكملها، بما في ذلك الأداة الوسيطة والوكيل. وأوضحت سولايمان أن الأداة الوسيطة، أي الأداة التي يستخدمها المستخدم للوصول إلى النموذج، تؤثر كثيرًا في أدائه، وأن نموذجًا أضعف مقرونًا بأداة وسيطة أفضل قد يتفوق بسهولة على نموذج من الطراز المتقدم.
وقالت: «تقييمات الأنظمة الوكيلة صعبة ومكلفة للغاية. لدينا ببساطة تقييمات أكثر للنماذج... ولا نملك العدد نفسه من التقييمات للأدوات الوسيطة، ونعمل على تطوير تقييمات أفضل للوكيل بصورته الشاملة، لأن هذا ما يستفيد منه كثير من الناس».
بعبارة أخرى، يبدو مجال التقييم في الوقت الراهن أشبه بساحة مفتوحة بلا ضوابط، وإذا كان لقياس الأداء أن يظل أداة مفيدة في نظر قادة الصناعة، فقد يصبح من الضروري اعتماد نهج أكثر توحيدًا على مستوى الصناعة بأسرها، يتفق عليه الجميع.