
تتسارع وتيرة الاستثمارات في تقنيات الصوت المدعومة بالذكاء الاصطناعي، إذ يضخ المستثمرون مليارات الدولارات في الشركات الناشئة التي تعمل في مجالات متعددة، بدءاً من بناء النماذج الأساسية وصولاً إلى خدمات دعم العملاء في المؤسسات، مروراً بتطبيقات تدوين الملاحظات في الاجتماعات والإملاء الصوتي الذكي.
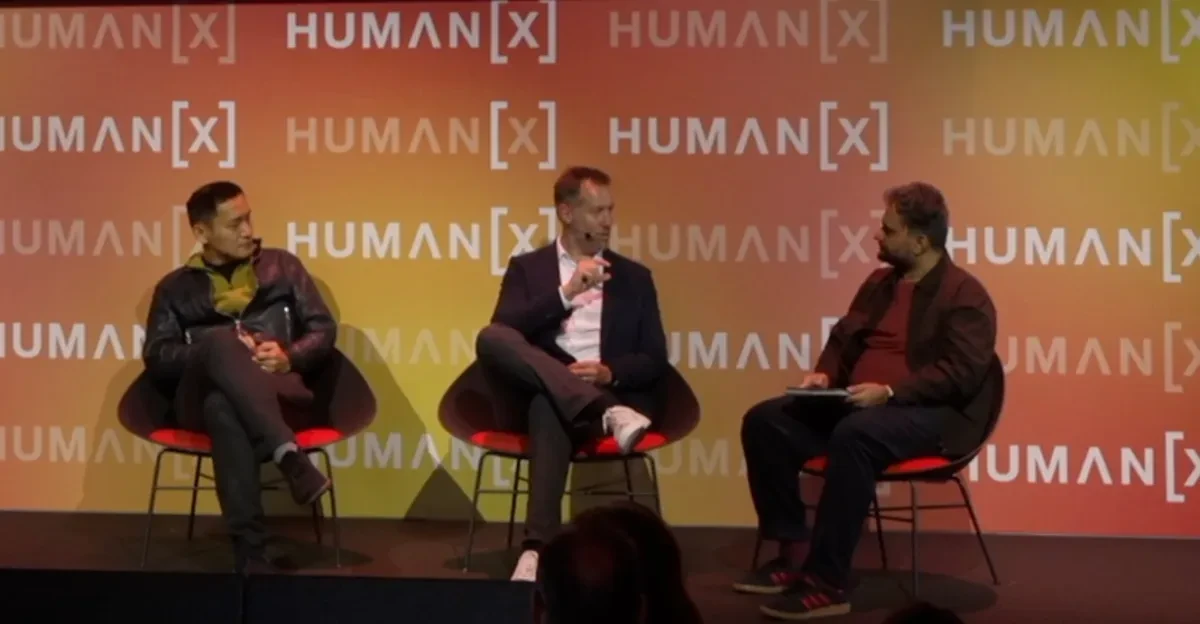
كل أسبوع تقريباً، تظهر أداة أو نموذج جديد يدّعي القدرة على محاكاة الصوت البشري في الحديث. لكن الواقع العملي، بحسب شون وين، كبير المسؤولين التقنيين في منصة «بولي إيه آي» (PolyAI) المتخصصة في الصوت الذكي للمؤسسات، لا يزال دون الطموح. وأوضح وين أنه على الرغم من ظهور النماذج القادرة على الاستماع والتحدث في آنٍ واحد، أي ما يُعرف بالنماذج ثنائية الاتجاه الكامل (full-duplex)، إلا أن تقنية الصوت الذكي لم تشهد بعد «لحظة تشات جي بي تي» الخاصة بها.
اقرأ أيضًا: جاس خيرا في ديزرابت 2026: معايير بلاكستون لبناء الجيل القادم من عمالقة الذكاء الاصطناعي
وقال وين في تصريحات له على هامش مؤتمر «هيومان إكس» (HumanX) الشهر الماضي: «لقد حققنا إنجازاً مهماً بتطوير النماذج ثنائية الاتجاه الكامل. لكن التحدي التالي هو جعل عملية التفكير سريعة للغاية، بحيث تتمكن النماذج من استخلاص الإجابات بسرعة، مما يجعل المحادثة طبيعية».
وأضاف وين أن وكلاء الذكاء الاصطناعي في خدمة العملاء يجب ألا يبدو صوتهم آلياً، بل ينبغي أن يمنحوا المتصلين الثقة الكافية في قدرتهم على حل المشكلات.
وتابع: «أعتقد أن المرحلة التالية ستكون مختلفة بعض الشيء. فبمجرد أن يصبح الصوت جيداً بما يكفي، ويبدأ العميل في التفاعل مع الوكيل لجولتين أو ثلاث، يبدأ العميل ببناء الثقة. ومع مرور الوقت، سيشعر أنه ربما لن يحتاج إلى التحدث مع بشري إذا كان الوكيل قادراً على حل مشكلته».
من جهته، رأى أليكس غاي، المدير التسويقي لتطبيق تدوين الملاحظات «أوتر» (Otter)، أن التعرف على المتحدث، وفهم النوايا، وربط ذلك بقاعدة المعرفة المؤسسية، هي خطوات أساسية لتمكين الأتمتة. وأوضح غاي أن الشركة تعمل أيضاً على تطوير «توائم رقمية» قد تمثل الأشخاص في الاجتماعات.
وأكد غاي أن جودة الصوت الناتج عن هذه التقنية أمر بالغ الأهمية، مشيراً إلى ضرورة أن يحمل الصوت الناتج نفس التعابير العاطفية التي يتميز بها الحديث مع إنسان في اجتماع حقيقي. وأضاف: «إذا فكرت في الاجتماعات التي تحضرها حالياً، فإن أفضل المحادثات هي تلك التي تجري فيها نقاشات واستراتيجيات، وتشعر أن هناك علاقة إنسانية تدعمها. إذا لم تتمكن من تحقيق ذلك مع الصورة الرمزية (avatar)، فسيكون الأمر مجرد أسئلة وأجوبة مع روبوت محادثة».
وعلى الرغم من التحسن الملحوظ في نماذج الصوت الذكي، لا تزال المساعدات الصوتية تواجه مشكلات في فهم المستخدمين، كما أن تطبيقات تدوين الملاحظات قد تُظهر نصوصاً أو ملخصات غير صحيحة.
وأرجع وين هذه المشكلة إلى أن نماذج التعرف التلقائي على الكلام (ASR) غالباً ما تفشل في التقاط الكلمات المفتاحية الهامة، مما يخلق إشكالية في استيعاب السياق الكامل للحديث. واتفق غاي مع هذا الرأي، مشيراً إلى أن شركته تواصل العمل على تحسين جودة النسخ الصوتي، وأن اللغة ما زالت أحد المجالات التي تحتاج نماذج الصوت إلى تطويرها.
وقال غاي: «بالنسبة لـ ’أوتر‘، لم تكن عملية النسخ الصوتي هي الهدف النهائي أبداً. كانت مجرد الطبقة الأساسية التي يمكننا من خلالها البدء في تحقيق مكاسب إنتاجية. لكن إذا لم تكن دقة النسخ الأولي بالمستوى المطلوب، فكل الإجراءات اللاحقة التي تبنى عليها ستكون معيبة. وبمجرد أن يبدأ النظام في اتخاذ إجراءات خاطئة، يفقد المستخدم الثقة في المنصة. من الضروري جداً أن نواصل تحسين نموذج التعرف التلقائي على الكلام، لأن تأثير أي خطأ في المراحل اللاحقة كبير».
كما تطرح الأدوات الصوتية الجديدة مسألة الشفافية. إذ ينبغي لهذه الأدوات أن تُعلم العملاء بأنهم قيد التسجيل أو أنهم يتحدثون مع ذكاء اصطناعي. وأكدت شركة «أوتر» أنها تسعى إلى غرس الثقة في نفوس المشاركين في الاجتماعات، ولذلك حتى في الاجتماعات التي لا يكون فيها البوت حاضراً، تحاول الشركة تطبيق أساليب مثل إشعار الجميع في الدردشة بأن الاجتماع قيد التسجيل. من جانبه، شدد وين من «بولي إيه آي» على أهمية توضيح حقيقة أن الأشخاص يتحدثون مع ذكاء اصطناعي في مكالمات المؤسسات.